Qu’est-ce que la sécurité des données liées à l’IA ?
La sécurité des données de l’IA protège contre les utilisations abusives, les fuites et les attaques les données, les modèles et les interfaces utilisés par les systèmes d’IA.
La sécurité des données de l’IA protège les données, les modèles et les interfaces utilisés par les systèmes d’IA contre les utilisations abusives, les fuites et les attaques.
La sécurité des données liées à l’IA englobe les pratiques, les contrôles et les technologies innovantes qui, ensemble, protègent les données, les modèles et les API d’IA contre tout accès non autorisé, toute utilisation abusive, toute manipulation ou toute fuite, et ce, tout au long du cycle de vie de l’IA. Elle va au-delà de la sécurité traditionnelle des données en mettant l’accent sur la sûreté des modèles, la sécurité de l’inférence et la protection des processus décisionnels de l’IA.
Sécurité des données de l’IA et sécurité traditionnelle des données
Les outils traditionnels de sécurité des données visent principalement à protéger les actifs, les environnements de stockage et les méthodes de transmission des données. Bien qu’ils permettent de contrôler efficacement l’accès aux données, de bloquer certaines menaces et d’empêcher les personnes non autorisées de consulter les données, ils ne peuvent pas sécuriser correctement les systèmes d’IA.
Les systèmes d’IA sont dynamiques et probabilistes. Des requêtes identiques adressées à un moteur d’IA générative peuvent produire des résultats différents selon leur contexte et leur intention. Les outils traditionnels ne peuvent évaluer ni ce contexte ni cette intention. Par conséquent, ils ne peuvent pas repérer les menaces dissimulées dans les requêtes, détecter les données d’entraînement corrompues ni identifier les tentatives visant à manipuler le processus décisionnel interne d’un système d’IA.
La sécurité des données d’IA analyse le contexte et l’intention afin de détecter les actions potentiellement malveillantes. Ces outils mettent en place des garde-fous autour des entrées et des sorties de l’IA afin d’assainir les données ingérées, d’examiner attentivement les invites adressées aux systèmes d’IA et de masquer les informations sensibles dans les résultats lorsque cela est nécessaire. Ils peuvent également imposer des limites aux agents afin d’éviter les comportements indésirables.
Pourquoi la sécurité des données de l’IA est aujourd’hui essentielle
Les systèmes d’IA et les infrastructures posent de nouveaux défis de sécurité qui vont au-delà de la protection traditionnelle des données. Les organisations doivent protéger les modèles, les interfaces API ainsi que les entrées et sorties susceptibles de divulguer des informations privées ou de tromper le système. La mise en place de mesures de protection renforce la sécurité globale.
L’IA générative, les applications basées sur les LLM et les systèmes autonomes reposent sur de vastes jeux de données et des flux de données continus, ce qui crée des vulnérabilités telles que l’empoisonnement des données, le vol de modèles, l’injection de prompts et l’exposition d’informations sensibles. À mesure que l’IA s’intègre aux applications destinées aux clients, aux workflows et aux processus décisionnels, la sécurité des données liées à l’IA devient essentielle pour atteindre des objectifs stratégiques majeurs, tels que la confiance, la continuité des activités et la conformité.
Comment les systèmes d’IA introduisent-ils de nouveaux risques ? Voici quelques exemples courants :
- Les systèmes d’IA peuvent divulguer des informations sensibles dans les résultats générés par les modèles.
- Les API d’IA introduisent de nouvelles surfaces d’attaque et des schémas d’attaque beaucoup plus fréquents.
- Les modèles peuvent être manipulés au moyen de prompts malveillants ou de données d’entrée adversariales.
- Les instantanés de modèles (points de contrôle), les représentations vectorielles (embeddings) et les données d’entraînement deviennent des actifs de propriété intellectuelle sensibles qui doivent être protégés.
- Les points de terminaison d’inférence doivent respecter des contraintes strictes en matière de latence, de mise à l’échelle et de politiques.
Atténuer les risques liés à l’IA fantôme et à l’exposition des données
Les risques internes liés à l’IA posent des défis majeurs en matière de protection des données. Les employés peuvent exposer involontairement des données en utilisant des outils d’IA non autorisés dépourvus de mécanismes de protection. Par exemple, ils pourraient copier des informations sur des clients, des éléments de propriété intellectuelle confidentiels ou du code source dans un système d’IA, sans savoir que ces données pourraient servir à entraîner le modèle d’une entreprise spécialisée dans l’IA. Par ailleurs, la saisie de données sensibles dans un moteur d’IA générative ou un outil de développement logiciel basé sur l’IA pourrait également exposer ces données à des menaces externes.
La sécurité des données de l’IA tout au long de leur cycle de vie
La sécurité des données d’IA doit accompagner les données et le modèle à chaque étape du cycle de vie de l’IA. Les approches traditionnelles reposant uniquement sur la sécurité périmétrique sont insuffisantes, car les actifs d’IA circulent entre différents environnements et interagissent de manière dynamique avec les utilisateurs, les applications et d’autres modèles. La sécurité doit être continue, intégrée et adaptée aux modèles.
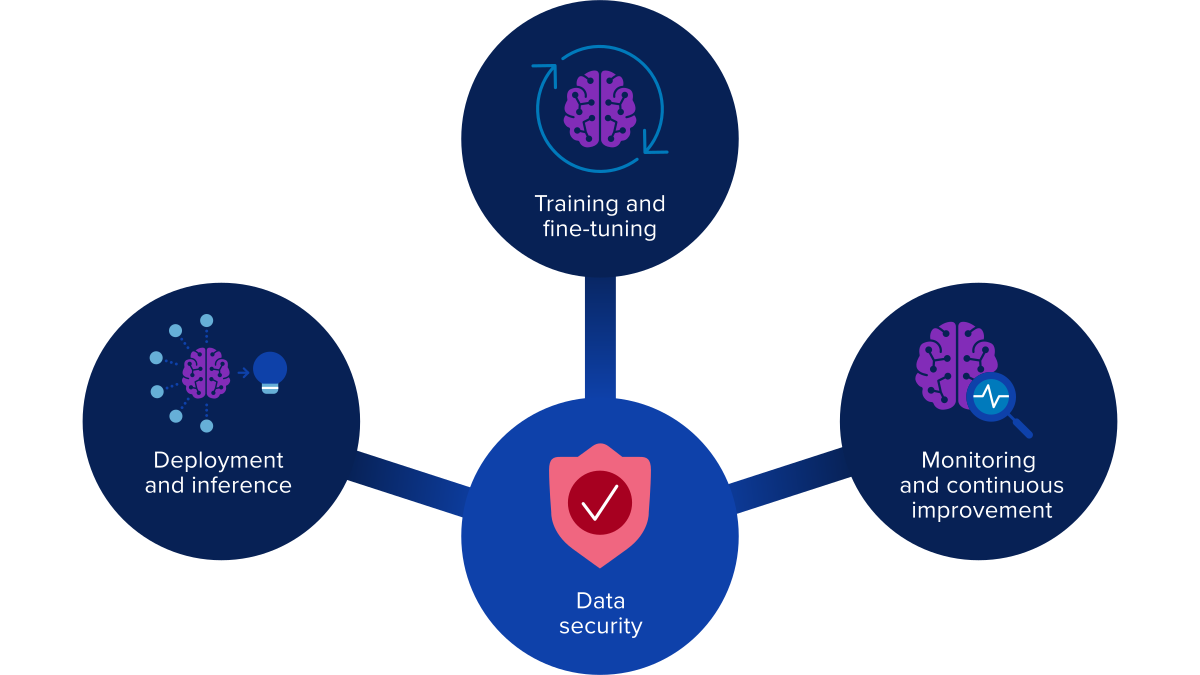
- Collecte et préparation des données : La sécurité de l’IA commence avant l’entraînement. L’ingestion et l’étiquetage des données, ainsi que l’ingénierie des caractéristiques, risquent d’exposer des informations sensibles au vol, aux accès non autorisés et à l’empoisonnement des données, qui consiste pour des attaquants à injecter des données manipulées afin de biaiser ou de dégrader le modèle. Une gouvernance rigoureuse, des mécanismes de validation et des contrôles d’accès sont indispensables avant l’intégration des données dans un pipeline d’IA.
- Entraînement et ajustement fin : Les données d’entraînement, les points de contrôle du modèle, les plongements et les gradients contiennent des informations sensibles. Une compromission lors de l’entraînement et de l’ajustement peut entraîner une altération du modèle, une perte de propriété intellectuelle, l’exposition de données réglementées et des manipulations adverses, modifiant ainsi durablement le comportement du modèle.
- Déploiement et inférence : Les API d’inférence sont des cibles privilégiées pour l’injection de prompts, la manipulation des résultats, l’extraction de modèles, la collecte de données et les attaques par surcharge. Les accès doivent être authentifiés et strictement contrôlés, et les entrées doivent être analysées afin de détecter tout comportement malveillant.
- Surveillance et amélioration continue : La dérive des modèles, les biais, les comportements préjudiciables et les utilisations non autorisées nécessitent une surveillance, une journalisation et un contrôle continus. Les opérateurs doivent détecter les anomalies, les schémas d’accès ainsi que les problèmes de sécurité ou de conformité.
Pourquoi une sécurité limitée au périmètre ne suffit pas à gérer cet environnement
Les charges de travail d’IA sont réparties entre les lacs de données, les clusters, les registres, les passerelles, les nœuds périphériques et les terminaux. La sécurité ne peut donc pas reposer sur un périmètre unique. La protection doit accompagner les données et les modèles tout au long de leur cycle de vie, en appliquant des mécanismes cohérents d’authentification et d’inspection, ainsi que des politiques uniformes, à chaque point d’interaction avec les utilisateurs, les applications ou les services.
Principes et contrôles fondamentaux pour la sécurité des données d’IA
Une sécurité efficace des données d’IA repose sur une combinaison de mesures de sécurité, de protection de la vie privée et de contrôles opérationnels :
- Gouvernance des données et analyses d’impact : Vérifier la légalité, la qualité des données, leur traçabilité et les implications en matière de confidentialité avant toute utilisation des données dans le développement de l’IA.
- Confiance zéro et principe du moindre privilège : Appliquez l’authentification et l’autorisation à chaque niveau, notamment pour les référentiels de données, les artefacts de modèles et les API d’inférence.
- Minimisation et anonymisation des données : Réduisez l’exposition des informations sensibles et attribuez aux jeux de données des étiquettes de sensibilité afin de permettre l’application des règles en aval.
- Protections au niveau des modèles : Sécurisez les points de contrôle, les plongements, les artefacts d’entraînement et les environnements d’accélérateurs.
- Inspection en temps réel des entrées et des sorties : Détectez les injections de prompts, les charges utiles malveillantes, les contenus toxiques ou les fuites accidentelles.
- Surveillance continue et supervision humaine : Indispensables pour les décisions à fort enjeu prises par l’IA et dans les secteurs réglementés.
- Gouvernance des API et du trafic : Veillez à ce que seules les requêtes validées atteignent les points de terminaison d’inférence.
Bien que les décisions de gouvernance soient prises en dehors du réseau, F5 les met concrètement en application en veillant à ce que seuls les sources de données, les identités et les services approuvés puissent accéder aux systèmes d’IA. Les services F5 Distributed Cloud et F5 BIG-IP appliquent un contrôle d’accès fondé sur des politiques, un routage tenant compte de la classification des données et des listes d’autorisation pour les API, afin que les flux de données d’entraînement et d’inférence respectent les règles de gouvernance approuvées.
Sécuriser les données d’IA en transit et au repos
Les pipelines d’IA reposent sur un flux continu de données, depuis leur ingestion jusqu’aux magasins de caractéristiques et aux points de terminaison d’inférence. La sécurisation de ces flux nécessite :
- Chiffrement des données en transit et au repos.
- Authentification et autorisation pour tous les accès à l’API.
- Conception sécurisée des API avec validation des schémas, limitation du débit et détection des menaces.
- Pare-feu d’application web (WAF), protection contre les attaques par déni de service distribué (DDoS) et contre les bots comme première couche de défense.
- Environnements segmentés pour isoler les données d’entraînement, les points de terminaison d’inférence et les artefacts de modèle.
- Inspection du trafic afin de détecter les anomalies ou les menaces dissimulées dans les canaux chiffrés.
F5 sécurise les pipelines de données d’IA en ajoutant une couche de contrôle en ligne en amont des passerelles et des points de terminaison des modèles. Des solutions telles que F5 Distributed Cloud Web App and API Protection (WAAP), F5 Distributed Cloud API Security, F5 BIG-IP Advanced WAF, F5 BIG-IP Access Policy Manager (APM), F5 BIG-IP SSL Orchestrator et F5 NGINX App Protect prennent en charge le protocole Transport Layer Security (TLS), l’authentification, la validation, la limitation du débit, le WAF, la protection contre les attaques DDoS, la défense contre les bots et l’inspection du trafic chiffré, afin que seules les requêtes vérifiées atteignent les modèles d’IA. Cela contribue à protéger les pipelines de données d’IA contre les charges utiles malveillantes, les accès non autorisés, les activités inhabituelles et l’exposition des données.
Lors de l’inférence, et dans l’ensemble de l’environnement d’IA, F5 associe des contrôles d’infrastructure et des contrôles propres à l’IA afin de sécuriser les interactions entre les modèles, les applications, les agents et les utilisateurs. F5 NGINX Ingress Controller, F5 Distributed Cloud Mesh et F5 BIG-IP Next Kubernetes peuvent contribuer à isoler les locataires, à segmenter les environnements et à appliquer des politiques de trafic et d’accès autour des charges de travail d’inférence. F5 AI Guardrails ajoute une inspection à l’exécution et une application des politiques propres à l’IA pour les invites, les réponses, les actions des agents et l’utilisation des outils. F5 AI Gateway régit l’accès aux modèles, aux agents et aux outils, tandis que F5 AI Red Team effectue des tests contradictoires sur les modèles, les applications et les agents afin d’identifier les faiblesses. F5 Workforce AI Security assure la visibilité et la gouvernance des usages autorisés et non autorisés de l’IA.
Contrôles avancés de la confidentialité et protection des données
Plusieurs techniques avancées peuvent aider les organisations à préserver la confidentialité et la sécurité des données sensibles lors de l’entraînement des modèles et de l’inférence en temps réel.
Lors de l’entraînement des modèles, les organisations doivent veiller à ce que les données d’entraînement brutes restent confidentielles et à ce que les modèles ne puissent pas faire l’objet d’une rétro-ingénierie permettant de reconstituer ultérieurement des données sensibles. Cela peut notamment inclure :
- Masquage des données et données synthétiques : Entraîne les modèles à l’aide de jeux de données générés par ordinateur qui simulent des données sans utiliser de véritables dossiers clients.
- Confidentialité mathématique (différentielle) : Injecte un bruit mathématique soigneusement calibré dans les données d’entraînement afin de réduire le risque que des informations sensibles sur des enregistrements individuels puissent être déduites ultérieurement à partir du modèle
- Apprentissage fédéré : Conserve les données réelles en toute sécurité sur des serveurs locaux, tout en envoyant uniquement les mises à jour des paramètres du modèle à un serveur central.
Pour protéger les données lors de l’inférence en temps réel, les organisations doivent adopter des mesures visant à limiter l’exposition potentielle des informations non chiffrées. Ces mesures comprennent :
- Masquage des données en temps réel : Supprime automatiquement les informations sensibles des requêtes des utilisateurs avant qu’elles n’atteignent le système d’IA, puis les restaure localement lors de l’envoi de la réponse.
- Coffres-forts matériels : Traite les requêtes d’IA au sein de puces chiffrées matériellement, empêchant ainsi toute entité non autorisée d’y accéder.
- Cryptographie avancée : Permet aux modèles d’IA d’analyser uniquement des données entièrement chiffrées et de fournir des réponses sans déchiffrer le fichier sous-jacent.
Sécuriser les modèles, les données d’entrée et les résultats
Les modèles d’IA présentent des exigences de sécurité spécifiques, notamment la sécurité des modèles, la sécurité des résultats et la compréhension de la sécurité grâce au contexte.
Sécurité des modèles consiste à protéger les points de contrôle, les plongements et les poids des modèles (valeurs numériques apprises) contre le vol, l’altération ou la réplication non autorisée. La sécurité des entrées, assurée par un pare-feu pour l’IA, doit filtrer et inspecter les invites et les charges utiles entrantes afin de détecter les menaces d’injection de prompt, les entrées adverses, les entrées contenant du code malveillant, ainsi que les entrées surdimensionnées ou malformées conçues pour saturer les systèmes et les faire planter.
La sécurité des sorties consiste à empêcher la divulgation de données sensibles, de propriété intellectuelle ou de contenus préjudiciables par le biais des résultats générés par l’IA.
Les solutions de sécurité traditionnelles ne tiennent pas compte des menaces propres à l’IA. Il convient donc de recourir à des pratiques telles que la gestion de la posture de sécurité de l’IA (AI-SPM) afin de surveiller en continu les configurations, les politiques et le comportement à l’exécution dans les environnements multicloud et hybrides, et ainsi détecter toute dérive ou erreur de configuration.
F5 fournit des contrôles multicouches pour contribuer à sécuriser les modèles d’IA, les entrées, les sorties ainsi que l’infrastructure applicative et API environnante. BIG-IP Advanced WAF, Distributed Cloud WAAP, Distributed Cloud API Security et NGINX App Protect peuvent être placés en amont des passerelles d’IA et des points de terminaison d’inférence afin d’authentifier les appelants, d’inspecter le trafic et d’appliquer des politiques de sécurité des applications et des API aux charges de travail d’IA. F5 AI Guardrails ajoute une inspection à l’exécution et une application des politiques propres à l’IA pour les invites, les réponses, les actions des agents et l’utilisation des outils ; F5 AI Gateway régit l’accès aux modèles, aux agents et aux outils ; F5 AI Red Team soumet les modèles, les applications et les agents à des tests contradictoires afin d’identifier leurs faiblesses ; et F5 Workforce AI Security assure la visibilité et la gouvernance des usages autorisés et non autorisés de l’IA.
AI Guardrails et Workforce AI Security ajoutent des fonctionnalités d’inspection et d’application des politiques propres à l’IA afin de contribuer à bloquer les injections de prompts, les fuites de données sensibles, les contenus préjudiciables et d’autres activités à risque. Workforce AI Security étend également la visibilité et la gouvernance aux usages autorisés et non autorisés de l’IA, aidant ainsi les organisations à comprendre quels outils d’IA sont utilisés, comment ils le sont et où des données sensibles ou des violations de politiques sont susceptibles de se produire.
Opérationnaliser la sécurité des données liées à l’IA
Les entreprises doivent intégrer la sécurité de l’IA à leurs processus existants :
- Intégration du DevSecOps et du MLOps : Consiste à intégrer des contrôles de sécurité aux pipelines d’entraînement et de déploiement. Cette approche permet de détecter rapidement les vulnérabilités, les erreurs de configuration et les flux de données à risque, afin d’éviter qu’ils n’atteignent les systèmes d’IA en production.
- Politiques internes claires : Elles encadrent l’utilisation sécurisée des outils d’IA internes comme externes. Ces politiques établissent des garde-fous afin de réduire au minimum les risques d’exposition accidentelle des données et d’empêcher toute utilisation abusive des services d’IA générative ou fournis par des tiers.
- Alignement réglementaire : consiste à garantir la conformité au règlement général sur la protection des données (RGPD), à la loi américaine sur la portabilité et la responsabilité en matière d’assurance maladie (HIPAA), à la loi californienne sur la protection de la vie privée des consommateurs (CCPA), aux règles sectorielles et aux nouvelles réglementations relatives à l’IA. Les entreprises doivent surveiller régulièrement les flux de données liés à l’IA et le comportement des modèles afin de respecter ces réglementations et ainsi éviter les amendes, les risques opérationnels et les dérives en matière de conformité.
- Modèle de responsabilité partagée : Assurer la sécurité de l’IA nécessite une collaboration entre les équipes chargées des réseaux, des données, de la sécurité des applications et des plateformes d’IA. Une protection efficace repose sur une répartition coordonnée des responsabilités afin d’éviter qu’une seule équipe ne devienne un goulot d’étranglement ou un angle mort dans la chaîne de traitement de l’IA.
- Formation des employés : Veillez à ce que les équipes maîtrisent les techniques de formulation sécurisée des prompts, la gestion des données et les consignes d’utilisation des modèles. Un personnel correctement formé est essentiel pour réduire au minimum les erreurs humaines, qui constituent l’une des principales causes de fuites de données et d’utilisations abusives liées à l’IA.
Conclusion
La sécurité des données de l’IA est essentielle pour développer en toute confiance l’utilisation de l’IA au sein d’une organisation. La protection des données, des modèles et des interfaces qui alimentent les systèmes d’IA nécessite des contrôles continus, une inspection intelligente et une gouvernance robuste à chaque étape du parcours de l’IA. En intégrant directement des fonctions intelligentes de sécurité et de gestion du trafic aux passerelles d’IA et aux points de terminaison d’inférence, F5 aide les organisations à appliquer le principe de confiance zéro, à prévenir les fuites de données, à bloquer les entrées malveillantes et à garantir des opérations d’IA fluides et conformes dans les environnements hybrides et multicloud.
Questions fréquentes
En quoi la sécurité des données liées à l’IA diffère-t-elle de la sécurité traditionnelle des données ?
La sécurité des données d’IA se distingue de la sécurité traditionnelle des données par son approche dynamique, adaptée aux systèmes d’IA contextuels. La sécurité traditionnelle des données protège les actifs statiques, le stockage des données et les méthodes de transmission des données. Ces solutions ne peuvent pas analyser le contexte et l’intention, pourtant essentiels pour identifier les menaces au sein des systèmes d’IA. La sécurité des données d’IA analyse ce contenu et cette intention, met en place des garde-fous autour des entrées et des sorties de l’IA, et définit des limites pour les agents d’IA.
Qu’est-ce que l’empoisonnement des données et comment les entreprises peuvent-elles le prévenir lors de l’entraînement de l’IA ?
L’empoisonnement des données consiste à tenter d’altérer les données d’entraînement d’un modèle d’IA afin que celui-ci produise des résultats inexacts ou biaisés lors de l’inférence. Pour prévenir ce type d’attaque, les entreprises doivent analyser les données avant l’entraînement, contrôler l’accès aux données d’entraînement, suivre les modifications qui leur sont apportées et mettre en œuvre des solutions pour protéger l’infrastructure d’entraînement ainsi que les données en transit.
Comment les pare-feu d’IA en ligne protègent-ils les LLM contre l’injection de prompts et les fuites de données ?
Les pare-feu d’IA en ligne protègent contre l’injection de prompts et les fuites de données en faisant office de proxy inverse placé devant les grands modèles de langage (LLM). Ils empêchent l’injection de prompts en analysant l’intention des entrées, en limitant les actions que le système d’IA peut effectuer et en inspectant les réponses. De même, ils protègent contre les fuites de données en masquant les données d’entrée, en limitant la récupération aux fichiers autorisés et en recherchant des informations sensibles dans les sorties.
Qu’est-ce qu’une nomenclature des composants d’IA (AI-BOM) et pourquoi est-elle essentielle à la sécurité des entreprises ?
Une nomenclature des composants d’IA (AI-BOM) répertorie tous les éléments d’un système d’IA. Elle doit inclure des informations non seulement sur les modèles et les jeux de données, mais aussi sur les relations de dépendance, les plongements vectoriels, les invites et les sources de récupération des données. L’AI-BOM offre une visibilité sur la chaîne d’approvisionnement de l’IA, ce qui aide les organisations à détecter et à corriger les éventuelles vulnérabilités de sécurité.
Comment F5 contribue-t-il à sécuriser les bases de données vectorielles et les architectures de génération augmentée par récupération (RAG) ?
F5 sécurise les bases de données vectorielles et les architectures RAG en assurant une protection en ligne sur l’ensemble du pipeline d’IA grâce à F5 Distributed Cloud. Au lieu de s’appuyer sur les contrôles d’accès intégrés aux bases de données ou aux environnements RAG, les entreprises peuvent utiliser F5 pour appliquer des mesures de sécurité, gérer le trafic et contrôler les identités au niveau des points d’entrée, des passerelles d’API et des couches réseau qui entourent les bases de données et les architectures.
Quelles fonctionnalités de F5 contribuent à la sécurité de l’IA en entreprise ?
La F5 AI Security Platform réunit AI Guardrails, Workforce AI Security, AI Gateway et AI Red Team pour aider les organisations à gouverner, tester et protéger les systèmes d’IA.
AI Guardrails aide à appliquer les politiques d’exécution et à se protéger contre des risques tels que l’injection de prompts, la fuite de données sensibles, les contenus préjudiciables et les actions non sécurisées des agents. Workforce AI Security assure la visibilité et la gouvernance des usages autorisés et non autorisés de l’IA, et permet d’inspecter les interactions avec l’IA et de leur appliquer des politiques. AI Gateway fournit un point de contrôle centralisé pour régir l’accès aux modèles, aux agents et aux outils, tandis qu’AI Red Team utilise des tests contradictoires pour détecter les vulnérabilités et les faiblesses des modèles, des applications et des agents.
Pour une protection plus étendue des applications, des API et des environnements distribués, la F5 Application Delivery and Security Platform (ADSP) offre notamment des fonctionnalités de protection des applications web et des API, de gestion des bots, d’atténuation des attaques DDoS et de mise à disposition des applications.
