À mesure que la virtualisation s’est imposée, divers indicateurs ont été proposés pour en mesurer la réussite. Les taux de consolidation, le nombre de machines virtuelles par administrateur, le délai de provisionnement et le pourcentage de serveurs virtualisés figuraient parmi les indicateurs les plus couramment utilisés pour mesurer et évaluer la réussite des projets de virtualisation.
Aujourd’hui, nous assistons à l’essor du DevOps, tandis que des indicateurs similaires sont proposés pour en mesurer la réussite. Le délai de mise sur le marché, le temps moyen de rétablissement, le délai de mise en œuvre des changements et la fréquence des déploiements figurent parmi les mesures les plus couramment évoquées lorsque l’on s’intéresse au « M » de la définition CAMS (Culture, Automatisation, Mesure, Partage) du DevOps.
Ces indicateurs sont pertinents et nécessaires, mais DevOps présente un avantage — un cas d’usage, si vous préférez — rarement évoqué et tout aussi essentiel : le passage à l’échelle des opérations.
C’est le même problème que le SDN tente de résoudre « au sein du réseau » par l’industrialisation des opérations : permettre aux équipes de changer d’échelle grâce à la technologie afin de suivre le rythme de croissance souhaité et constaté par l’entreprise, sous l’effet de l’essor rapide des applications mobiles et web. Il s’agit d’un problème classique de type « 30/30/3 », où la croissance des données entraîne une hausse des coûts informatiques (pour leur transport, leur traitement et leur stockage), tandis que les revenus n’augmentent que très peu. Pour résoudre ce problème, il faut se concentrer sur le seul élément de l’équation que nous pouvons maîtriser : la hausse des coûts informatiques. Alors, si vous voulez appeler cela le SDN, libre à vous. Si vous préférez parler de DevOps pour le réseau, allez-y. Et pourquoi pas SDDC ? Vous pouvez aussi appeler cela le cloud, si c’est votre truc. Tous reposent sur un même principe : une mise à l’échelle rapide des opérations est essentielle à la croissance.
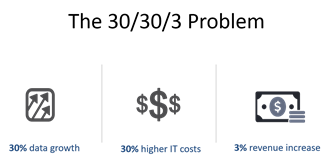
Il ne s’agit pas seulement des ressources matérielles et logicielles, mais aussi de la manière dont nous les provisionnons et les gérons. Il est nécessaire de réduire les efforts requis pour gérer l’ensemble des ressources — matérielles et logicielles — nécessaires au déploiement et à la mise à disposition d’une application.
C’est là que le « A » d’« automatisation » prend tout son sens : il permet de réduire les coûts informatiques nécessaires pour modifier l’équation de croissance et atteindre l’échelle requise afin de soutenir une croissance accrue de l’entreprise.
Mais nous ne devons pas nous contenter d’une vision superficielle de l’automatisation. S’il est important d’automatiser (en utilisant des scripts et des outils d’orchestration pour piloter le provisionnement, la gestion et les processus opérationnels nécessaires au déploiement des services et des applications), n’oublions pas le rôle essentiel que joue l’« infrastructure en tant que code ».
Pour ce faire, nous pouvons notamment remonter dans le temps et examiner comment la virtualisation a permis de gérer les ressources de calcul à grande échelle, en grande partie grâce au traitement de cette infrastructure « comme du code ».
Je sais, je sais, ce n’était pas vraiment du code au sens où il ne s’agissait ni d’un script, ni d’un fichier de configuration, ni de quoi que ce soit qui ressemblait à du « code ». Mais c’était traité « comme du code », dans la mesure où nous utilisions des référentiels centralisés d’« images de référence » permettant de provisionner et de configurer rapidement des serveurs : serveurs web, serveurs d’applications, serveurs de données. Les différents types de serveurs étaient standardisés à l’aide d’une « image » prédéfinie qui permettait aux équipes d’exploitation de passer à l’échelle.
Et quand je parle d’échelle, je veux dire à TRÈS GRANDE ÉCHELLE. Malgré les nombreux chiffres avancés, il n’était pas rare, dès 2011, de trouver des organisations affichant un ratio administrateur/serveurs virtuels de 1 pour 350. Certaines annonçaient même des ratios allant de 1 pour 500 à 1 pour 1 000, tandis que d’autres, simplement limitées par la taille de leur organisation, ne pouvaient revendiquer que 1 pour 100 ou 1 pour 150. Un rapport de 2012 analysant les données de plusieurs études comparatives informatiques indiquait un ratio administrateur/serveurs de 1 pour 50 à 75 pour les serveurs physiques et de 1 pour 185 à 450 pour les serveurs virtuels.
En matière de mise à l’échelle, c’est remarquable. Cela permet de soutenir la croissance sans l’augmentation des coûts informatiques qui l’accompagne habituellement.
À présent, considérez que le ratio médian ingénieur/appareils, toutes tailles d’entreprise confondues, est d’environ 1 pour 36. C’est intéressant en soi, vous ne trouvez pas ? Ce ratio ne semble pas évoluer à mesure que l’entreprise se développe. Ce qui est plutôt problématique et ne fait qu’aggraver le problème des 30/30/3.
Mais si nous pouvions changer cela d’une manière ou d’une autre, ne serait-ce qu’en doublant le nombre d’appareils par ingénieur, nous réduirions les coûts liés à la croissance tout en permettant à l’ensemble du réseau de mieux passer à l’échelle. Pour y parvenir, nous devons reproduire le succès de la virtualisation. Pas nécessairement en utilisant la virtualisation, mais en adoptant les concepts qui lui ont permis d’atteindre des ratios administrateurs/serveurs incroyables : l’infrastructure en tant que code et l’automatisation.
Si nous ne pouvons pas simplement créer des images de référence pour les commutateurs, les répartiteurs de charge et la vingtaine d’autres services applicatifs L4-7 que les entreprises utilisent pour fournir et sécuriser leurs applications, c’est parce que chaque configuration est unique et centrée sur l’application. Cela signifie que, même si vous pouvez tout à fait opter pour une solution logicielle (virtuelle) et déployer une image de base de référence pour n’importe lequel de ces services, vous aurez toujours besoin de quelqu’un pour effectuer la configuration. Et celle-ci est loin d’être simple.
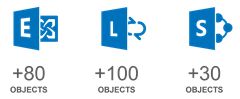
Vous configurez des services applicatifs pour Exchange ? Plus de 80 objets différents doivent être créés, configurés et associés correctement pour garantir la disponibilité, les performances et la sécurité requises.
C’est certainement là que le temps (et les coûts qui y sont associés) est consacré « au niveau du réseau ».
C’est donc à ce niveau que nous devons passer à l’échelle. Là où nous devons traiter l’infrastructure « comme du code ».
C’est pourquoi la création de modèles est incluse dans le « A » d’Automatisation de DevOps. Elle permet en effet aux équipes chargées des opérations réseau (et de sécurité) de traiter les configurations courantes « comme du code », pouvant être géré dans un référentiel central. Le modèle devient alors l’« image de référence » à partir de laquelle les services applicatifs sont provisionnés et configurés. Cette approche permet une automatisation et une orchestration similaires à celles du provisionnement des machines virtuelles, et constitue le socle de l’évolutivité opérationnelle dont les organisations ont besoin pour soutenir la croissance de leur activité.
Le DevOps, le SDN, le SDDC et même le cloud ne servent pas uniquement à accélérer la mise sur le marché ou à réduire les coûts opérationnels. Ils sont également essentiels pour évoluer efficacement et ainsi favoriser la croissance de l’entreprise au lieu de l’entraver. Le coût lié au recrutement d’un nombre toujours plus important d’opérateurs ou d’ingénieurs pour gérer les ressources croissantes dans l’ensemble du centre de données (calcul, réseau, sécurité, stockage) finira par engloutir les bénéfices de croissance générés par cette montée en charge. Évoluer plus efficacement grâce à l’automatisation et traiter l’infrastructure comme du code peut constituer un moyen de gérer la montée en charge nécessaire pour soutenir la croissance visée par l’entreprise.
À propos de l’auteur

Lori MacVittie est ingénieure émérite et évangéliste en chef au sein du bureau du directeur technique de F5. Elle possède une expertise approfondie dans la fourniture d’applications, les stratégies d’automatisation et les infrastructures. Elle est réputée pour sa capacité à rendre la complexité intelligible, qu’elle définisse des garde-fous pour les agents d’IA, analyse des architectures multicloud fragiles ou explore les limites des systèmes évolutifs. Elle cumule plus de trente ans d’expérience dans le secteur, couvrant le développement d’applications, l’architecture informatique ainsi que l’exploitation des réseaux et des systèmes. Avant de rejoindre F5, elle a été rédactrice spécialisée dans les technologies et a reçu plusieurs distinctions. MacVittie est titulaire d’un master en informatique et est une autrice prolifique dont les publications couvrent la sécurité, le cloud et l’architecture d’entreprise. Elle est également une passionnée de jeux de société et de jeux vidéo, et assume pleinement ses avis bien tranchés sur le fromage.
Autres articles de Lori Mac VittieArticles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.
L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
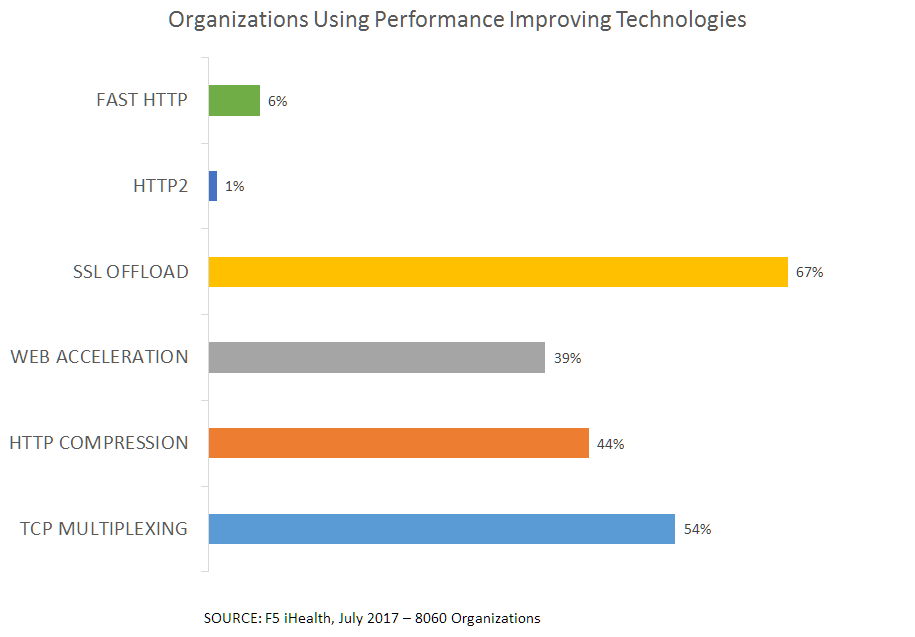
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.